
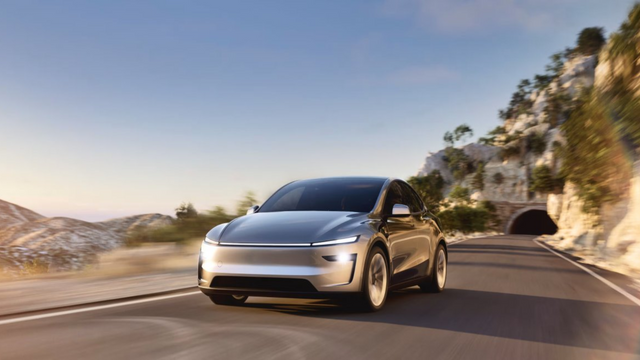

Tesla sa spolieha na simulované údaje, aby neustále zlepšoval systém Full Self-Driving (FSD). Použitím syntetického tréningového materiálu – tiež nazývaného „Simulated Content“ – sa Tesla darí cielene pripraviť FSD na rôzne výzvy a hraničné prípady. V tomto príspevku sa dozvieš, ako Tesla používa simulované údaje na optimalizáciu bezpečnosti a efektívnosti autonómneho riadenia.
Použitie simulovaných údajov na optimalizáciu FSD
-
Základ tréningových údajov:
Kvôli obmedzeniam v Číne nemôže Tesla posielať tréningové údaje do zahraničia. Namiesto toho je systém FSD trénovaný pomocou všeobecného modelu a synteticky generovaných údajov. -
Prístup len s víziou:
Tesla sa spolieha výlučne na Tesla Vision – kamery zachytávajú vizuálne údaje, ktoré vytvárajú 3D prostredie vozidla. Tieto informácie tvoria základ pre rozhodnutia a správanie pri jazde bez spoliehania sa na radar. -
Supervised Learning:
Tréning prebieha prostredníctvom modelu učenia pod dohľadom, pri ktorom sú reálne, manuálne alebo automaticky označené údaje kombinované so synteticky generovaným obsahom. Tieto „Ground Truth“ údaje umožňujú systému presne rozpoznať objekty a scenáre.
Výhody a aplikácia simulovaného tréningu
-
Úspora nákladov:
Generovaním syntetických údajov odpadávajú nákladné a časovo náročné procesy ako zber, prenos a spracovanie údajov. -
Tréning v extrémnych podmienkach:
Simulovaný obsah umožňuje Tesla pripraviť FSD na zriedkavé alebo nebezpečné jazdné situácie – ako napríklad silný dážď, hmla alebo nočné jazdy – bez toho, aby bolo potrebné tieto podmienky skutočne vyvolať. -
Pokrytie hraničných prípadov:
Zriedkavo sa vyskytujúce, ale bezpečnostne relevantné situácie, ako neočakávané prekážky alebo nezvyčajné správanie iných účastníkov cestnej premávky, sú cielene simulované, aby sa systém stal robustnejším. -
Neustála optimalizácia:
Možnosť kedykoľvek generovať nové, rôznorodé tréningové súbory údajov umožňuje Tesla neustále zdokonaľovať FSD a prispôsobovať ho aktuálnym podmienkam.
Simulovaný obsah ako kľúč k bezpečnej autonómii
Tesla opisuje použitie syntetických tréningových dát vo svojom patente „Vision-Based System Training with Synthetic Content“.
-
Atribúty modelu obsahu:
Simulované dáta sú založené na atribútoch, ktoré sú extrahované z reálnych, označených dát. Tieto atribúty – ako napríklad okraje ciest, značenie vozovky alebo pohyblivé objekty – sú variované, aby sa zobrazila široká škála jazdných scenárov. -
Kontextové označovanie:
Okrem vizuálnych vlastností sú do dát integrované aj ďalšie kontextové informácie ako počasie, denná doba a prostredie. To poskytuje systému FSD komplexnejšie pochopenie jazdnej situácie a zlepšuje rozhodovanie v situáciách v reálnom čase.
Záver
Tesla využíva simulované dáta na efektívny a nákladovo efektívny rozvoj systému FSD. Kombináciou reálnych a syntetických tréningových dát môže byť systém pripravený na rôzne a zriedkavé jazdné scenáre, čo vedie k bezpečnejšiemu a robustnejšiemu autonómnemu riadeniu. Neustála optimalizácia prostredníctvom simulovaného obsahu sľubuje, že rozhodujúcim spôsobom ovplyvní budúcnosť autonómneho riadenia.

Hat dir unser Beitrag gefallen?
Wenn du bereits stolzer Tesla-Fahrer bist oder es zeitnah werden solltest, besuche unseren Onlineshop Shop4Tesla und sichere dir 10% Rabatt auf alle Produkte mit dem Rabattcode: NEWS4TESLA. In unserem umfangreichen Sortiment findest du eine Vielzahl an hochwertigen Tesla-Zubehörteilen für jedes Modell. Entdecke spannende Innovationen und Zubehör, die dein Tesla-Erlebnis noch besser machen - shop4tisla.com.